Capítulo 5 — Memória¶
Neste capítulo você vai aprofundar os diversos tipos de memória de um computador moderno — da memória RAM volátil, passando pela hierarquia de cache dentro do processador, até a memória secundária persistente em suas variantes magnética, de estado sólido (flash) e ótica — e a relação direta entre a natureza física da célula de memória e o desempenho do sistema. O Capítulo 1 já introduziu a distinção entre memória RAM e armazenamento secundário e apresentou, na Seção 1.10, a pirâmide de hierarquia de memória; este capítulo não repete essa introdução, mas aprofunda cada uma de suas camadas.
5.1 Da célula de memória às características da memória¶
O Capítulo 2 (§2.4) construiu a célula de memória mais básica, o flip-flop, e o Capítulo 4 (§4.5) mostrou que cada núcleo do processador tem as suas próprias caches. Este capítulo percorre, uma a uma, as camadas da pirâmide de memória da Seção 1.10 — e um princípio orienta toda a discussão: as características de uma memória — velocidade, custo, volatilidade, durabilidade — não são arbitrárias; elas decorrem diretamente da natureza física da sua célula de memória, isto é, do mecanismo usado para armazenar um único bit.
Uma célula de memória é, em essência, um combinado, no mesmo sentido da Seção 2.2.1: um dispositivo físico ao qual se atribui o significado "0" ou "1". Esse combinado pode ser implementado de formas radicalmente diferentes — um circuito com transistores, um capacitor carregado, uma região magnetizada, um ponto que reflete ou não reflete luz —, e é exatamente essa diferença de implementação que separa memória primária de memória secundária, e que separa, dentro da própria memória secundária, um HD de um SSD ou de uma mídia ótica.
Para transformar uma célula isolada num chip de memória, basta replicá-la em grade — cada célula recebe um endereço próprio (uma organização linha/coluna, como uma planilha invertida: primeiro a linha, depois a coluna) — e conectar todas as células aos mesmos barramentos de endereço e de dado. É esse compartilhamento físico de barramento que explica por que a RAM tem acesso aleatório: o endereço e o dado chegam, por tensão elétrica, simultaneamente a todas as células ao mesmo tempo; apenas a célula cujo endereço foi ativado responde, gravando ou lendo o dado — o mesmo papel dos sinais de habilitação da Seção 2.4.1 — não há deslocamento físico até a posição, ao contrário do que ocorre no HD (Seção 5.10). Por isso o tempo de acesso é o mesmo, não importa qual endereço seja escolhido.
Nota prática. Sempre que um chip de hardware exibir uma estrutura visivelmente repetitiva de blocos idênticos — como os retângulos pretos de um pente de RAM —, é sinal de que aquele componente é memória: cada bloco é a réplica de uma mesma célula básica, repetida até atingir a capacidade total do chip.
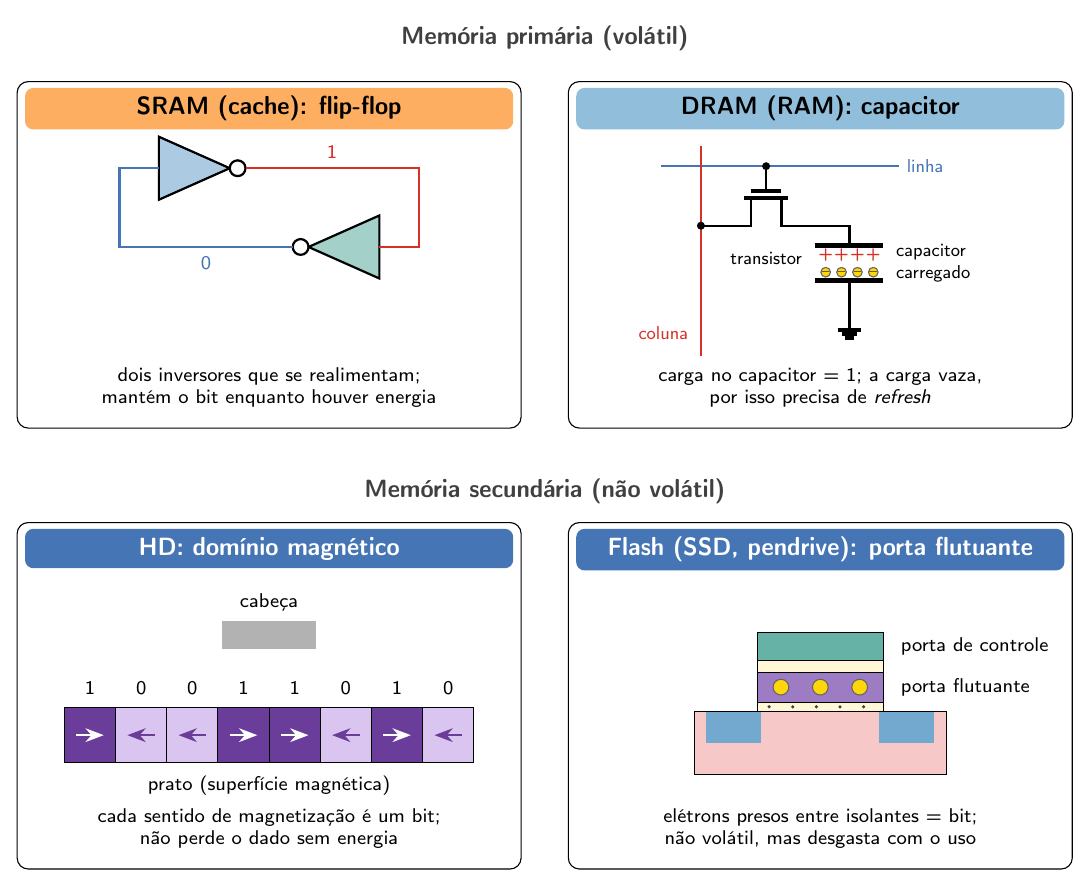
Cada painel da Figura 5.1 mostra o mecanismo físico que guarda um bit: no flip-flop, o próprio circuito mantém o valor enquanto está energizado; na DRAM, a carga de um capacitor, que vaza com o tempo; no HD, o sentido da magnetização de uma pequena região do prato; na flash, elétrons presos numa porta isolada. As duas primeiras perdem o dado sem energia (memória volátil); as duas últimas não.
5.2 Memória estática (SRAM)¶
A primeira célula a examinar é a que o Capítulo 2 (§2.4) já construiu: o flip-flop, feito de portas lógicas e, em última instância, de transistores (§2.2). Uma memória cujas células são flip-flops é chamada estática.
Apesar de ser a célula mais direta, a memória estática nunca foi a tecnologia dominante de memória primária: da década de 1950 até o início dos anos 1970, esse papel coube à memória de núcleo magnético e, desde então, à memória dinâmica (DRAM, Seção 5.3) [1]. O uso da memória estática sempre se concentrou nas memórias cache (Seção 5.8), pelo motivo de custo e densidade explicado adiante nesta seção.
Uma vez que um valor é escrito num flip-flop, ele permanece estável indefinidamente enquanto houver energia — daí o nome "estática". Essa estabilidade é o que torna a SRAM (Static RAM) extremamente rápida.
A contrapartida da SRAM é o custo: por unidade de armazenamento, uma célula estática é significativamente mais cara e menos densa do que a alternativa dinâmica apresentada a seguir. Por isso, a aplicação da SRAM se concentra nas memórias cache dentro do processador (Seção 5.8).
É importante mencionar que a memória estática ganhou esse nome de forma retroativa, para contrapor-se à chegada da memória dinâmica, que é estudada na próxima seção.
5.3 Memória dinâmica (DRAM) e a operação de refresh¶
A memória dinâmica (DRAM, Dynamic RAM) armazena cada bit em um capacitor — um componente que guarda carga elétrica, e não um valor lógico estável por natureza. Um capacitor perde carga ao longo do tempo, o que significa que a informação armazenada se degrada progressivamente — como um balde furado, que precisa ser completado periodicamente para não esvaziar.
Esse "completar periodicamente" é a operação de refresh: em intervalos regulares, o controlador de memória relê e regrava cada célula da DRAM para restaurar a carga elétrica antes que ela caia a ponto de tornar ambíguo se o bit é 0 ou 1. O termo é o mesmo usado para a atualização de uma página web (F5): uma releitura periódica que traz o conteúdo de volta ao estado esperado.
A necessidade de refresh torna a DRAM mais lenta do que a SRAM. Em compensação, sua célula é mais simples (um transistor e um capacitor, em vez dos seis transistores de uma célula SRAM típica), o que permite maior densidade de memória — mais bits armazenados no mesmo espaço físico — e, consequentemente, um custo por bit muito menor.
É essa relação custo–densidade–velocidade que explica por que a DRAM, apesar de mais lenta que a SRAM, tornou-se a tecnologia usada como memória RAM principal de praticamente todos os computadores modernos.
5.4 Sincronismo e a família SDRAM/DDR¶
A geração seguinte de memória dinâmica introduziu o sincronismo: em vez de operar de forma assíncrona, a memória passou a coordenar suas operações com um sinal de clock (o mesmo sinal que sincroniza o flip-flop na Seção 2.4) — um sinal digital que alterna regularmente entre nível alto e nível baixo. As operações de leitura e escrita só são processadas quando o clock está em um determinado estado, o que evita instabilidades elétricas durante a transição de valores no circuito. Essa é a SDRAM (Synchronous Dynamic RAM): dinâmica (usa capacitores e precisa de refresh) e síncrona (usa clock).
A frequência desse clock, medida em megahertz (MHz) ou gigahertz (GHz), determina quantas operações de leitura/escrita a memória realiza por segundo — é o número de frequência de trabalho estampado na embalagem de qualquer memória RAM vendida no mercado.
A partir da SDRAM, o mercado consolidou a tecnologia DDR (Double Data Rate), que transfere dados nas duas bordas do sinal de clock — na subida e na descida —, fazendo duas transferências por ciclo (daí o nome Double Data Rate). Por isso, o número anunciado num módulo DDR (por exemplo, "DDR4-3200") é, a rigor, a taxa de transferências por segundo — 3.200 milhões de transferências por segundo (MT/s) —, o dobro da frequência real do clock, de 1.600 MHz. As gerações sucessivas — DDR2, DDR3, DDR4, DDR5 — aumentaram a taxa de transferência principalmente elevando a frequência da interface entre a memória e o controlador e o volume de dados buscado internamente a cada acesso, além de aumentar a densidade da célula e reduzir a tensão de operação [20]. A tabela a seguir resume as gerações mais encontradas hoje em bancada:
| Geração | Taxa de transferência por pino (aprox.) | Tensão de operação | Observação |
|---|---|---|---|
| DDR3 | ~1,6 Gb/s | 1,5 V | Tecnologia madura, hoje mais cara por menor oferta |
| DDR4 | ~3,2 Gb/s | 1,2 V | Tecnologia dominante no mercado atual |
| DDR5 | ~4,8–6,4 Gb/s | 1,1 V | Maior capacidade por módulo; ainda mais cara por menor adoção |
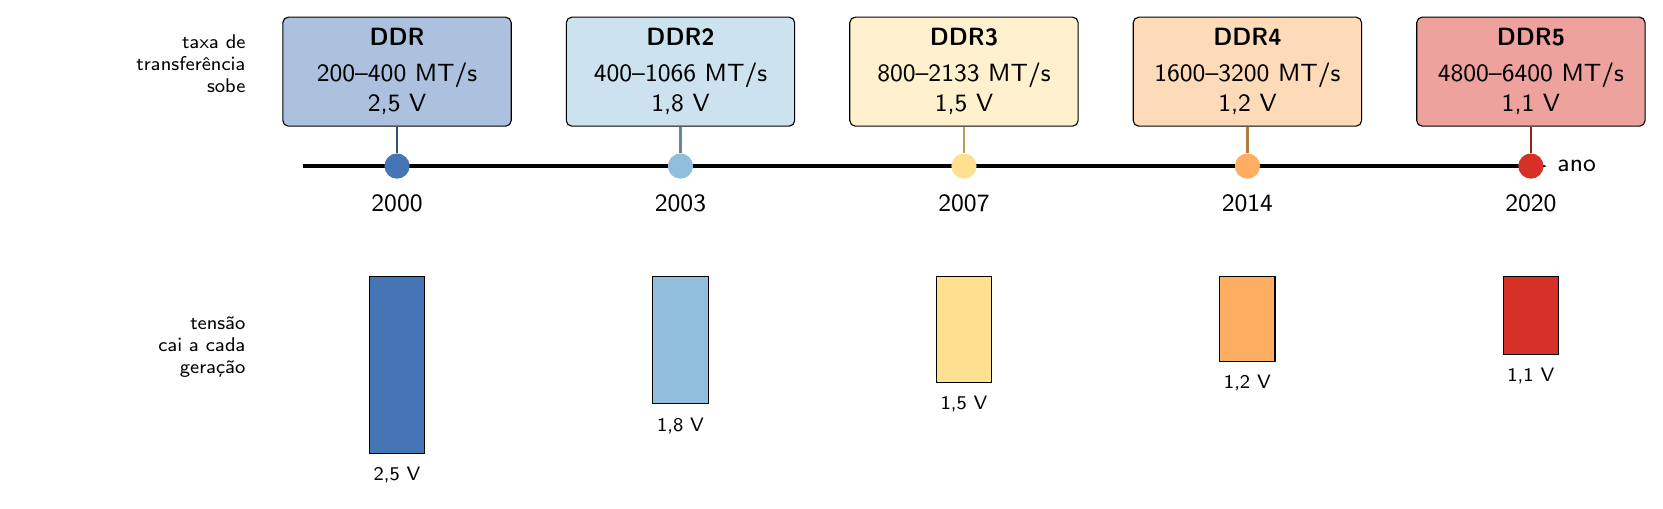
A Figura 5.2 estende a tabela às cinco gerações, com as faixas de taxa de transferência previstas no padrão de cada uma (em milhões de transferências por segundo, MT/s) e a tensão nominal: a taxa sobe e a tensão cai a cada geração.
Valores de taxa de transferência e tensão conforme especificação JEDEC [2].
CAS Latency (CL). Além da frequência de trabalho, memórias RAM anunciam também um conjunto de números chamado timings, o mais citado sendo o CL (CAS Latency, de Column Address Strobe Latency): o número de ciclos de clock que a memória leva entre receber o endereço de uma coluna de dados e efetivamente disponibilizar esse dado. Como o CL é medido em ciclos — não em tempo absoluto —, comparar o CL de memórias com frequências de trabalho diferentes não é direto: o mesmo CL pode representar tempos reais bem distintos dependendo da frequência. Na prática, diferenças de CL costumam ser imperceptíveis em uso cotidiano, ficam um pouco mais visíveis em jogos, e só se tornam significativas (até ~15% de ganho) em aplicações profissionais que manipulam grandes volumes de dados [12].
A tensão de operação cai a cada geração por causa da equação que descreve a potência gasta nas comutações de um circuito digital [21]:
em que \(V\) é a tensão de operação, \(f\) a frequência do clock, \(C\) a capacitância das ligações que o circuito precisa carregar e descarregar a cada mudança de nível, e \(\alpha\) a fração dos circuitos que de fato muda de estado a cada ciclo. Como a tensão entra ao quadrado, passar de 1,5 V (DDR3) para 1,2 V (DDR4), por exemplo, reduz a potência para cerca de 64% (1,2² ÷ 1,5² ≈ 0,64), mantidos os demais termos. Menos energia gasta significa também menos calor dissipado por efeito Joule — a mesma lógica que, no processador, acompanha a redução da litografia (Capítulo 4, §4.3).
Exemplo. Numa pesquisa de preços real num site de varejo de hardware, uma memória DDR3 de 4 GB a 1600 MHz custava R$ 169,99, enquanto uma memória DDR4 de 8 GB — o dobro da capacidade e de uma tecnologia mais recente — custava R$ 129,49, um valor menor. A explicação não é técnica, mas de mercado: pela lei da oferta e da procura, uma tecnologia em fim de vida (DDR3) fica mais cara à medida que sua oferta diminui, mesmo sendo tecnologicamente inferior a uma tecnologia mais nova e mais barata (DDR4) que está no auge de sua adoção. Algo parecido, por razão oposta, acontecia com a DDR5, então no início de sua adoção: um kit de 2×16 GB custava R$ 1.139 — cerca do dobro do preço por gigabyte de um kit DDR4 equivalente —, mostrando que montar um computador de última geração tem um custo-benefício pior no curto prazo, embora garanta maior disponibilidade de peças de reposição no médio prazo.
Atualização de mercado (2026). A partir da expansão de cargas de trabalho de IA e da demanda de servidores por memória em larga escala, o preço de módulos DDR5 subiu a ponto de o ganho de desempenho sobre DDR4 deixar de compensar a diferença de custo — por isso, mesmo em computadores novos, DDR4 seguiu sendo, no mercado brasileiro de 2026, o "sweet spot" de custo-benefício, e o ciclo de vida comercial do DDR4 se estendeu mais do que o normalmente esperado para uma geração de memória.
Cada geração tecnológica também define um limite de capacidade por módulo: no segmento de desktop/consumidor, um slot de memória DDR4 comporta tipicamente um módulo de até 32 GB (módulos de capacidade maior existem, mas apenas na forma de módulos registrados — RDIMM/LRDIMM — voltados a servidores, com engenharia e custo diferentes; Capítulo 1, §1.11.2) [3]. Numa placa-mãe de desktop com quatro slots, a capacidade total possível de memória primária é, portanto, de até 128 GB — mas apenas dentro da mesma geração tecnológica: não é possível combinar um módulo DDR4 com um DDR5 na mesma máquina, tanto por incompatibilidade elétrica quanto física (Seção 5.6).
5.4.1 VRAM: a mesma tecnologia aplicada à GPU¶
A GPU, como qualquer processador, não realiza computação sem memória associada — e a indústria resolveu essa necessidade com uma memória RAM dedicada exclusivamente ao processamento gráfico, chamada VRAM (Video RAM). Em essência, a VRAM é a mesma coisa que a RAM principal — uma memória de acesso aleatório, construída com a mesma família de tecnologias — só que otimizada especificamente para o padrão de acesso do hardware gráfico.
Por serem submódulos de hardware independentes — CPU e RAM principal de um lado, GPU e VRAM de outro, na lógica de modularidade da Seção 1.6.2 —, cada par evolui no seu próprio ritmo de mercado: é perfeitamente possível uma máquina ter RAM DDR3 convivendo com uma VRAM de geração bem mais recente, porque a GPU segue sua própria linha de evolução, batizada de família GDDR (Graphics DDR) em vez de DDR.
Essa separação tem um custo. Sempre que um dado precisa ser processado pela GPU, ele tem que ser copiado da RAM principal para a VRAM, processado ali, e o resultado trazido de volta — esse ir e vir consome tempo, chamado de overhead de comunicação — uma versão, entre duas memórias, do gargalo de von Neumann (Capítulo 2, §2.7). Em aplicações que programam a GPU diretamente (como CUDA, da NVIDIA — usado, por exemplo, em processamento de imagens de tomografia computadorizada), esse gerenciamento de memória é feito manualmente pelo desenvolvedor, ao contrário de um programa comum que roda inteiramente na CPU. É por isso que uma VRAM maior importa na prática: quanto mais dados cabem de uma vez na VRAM, menos vezes esse overhead de ida e volta precisa acontecer (ver também Seção 5.7 sobre memória unificada, uma estratégia alternativa que elimina esse overhead aproximando fisicamente RAM e VRAM).
5.5 Overclock, underclock e a tríade memória–placa-mãe–processador¶
A frequência anunciada na embalagem (Seção 5.4) nem sempre é aquela em que a memória de fato trabalha. Elevar a frequência de trabalho de um componente acima de sua especificação nominal é chamado de overclock; o inverso — reduzir a frequência de trabalho abaixo do especificado — é o underclock.
A frequência de trabalho de uma memória RAM não é uma propriedade isolada: ela precisa estar compatibilizada com a placa-mãe e com o processador. Se a memória suporta uma frequência mais alta do que a placa-mãe ou o processador conseguem sustentar, o sistema realiza um underclock automático de todo o conjunto para garantir estabilidade — em vez de operar na velocidade máxima anunciada da memória, o conjunto passa a operar na velocidade máxima que o elo mais fraco da cadeia suporta.
Nota prática. Um computador instável, travando com frequência, pode ter como causa uma memória configurada para trabalhar acima da frequência que a combinação placa-mãe/processador suporta de forma confiável. Reduzir manualmente essa frequência (um underclock deliberado) costuma resolver o travamento ao custo de uma perda de desempenho geralmente irrelevante na prática.
Nota prática (diagnóstico de módulo defeituoso). Quando um computador não passa no POST (Capítulo 9, §9.1.1) e a memória RAM é uma das hipóteses em aberto, o diagnóstico começa pelo mais físico e barato antes de qualquer ferramenta de software — exatamente o princípio de priorizar a hipótese mais barata de verificar, discutido no Capítulo 12 (§12.4):
- Reencaixar o módulo. Um encaixe parcial, sem os contatos dourados totalmente assentados no slot, já é suficiente para impedir o POST — e é a causa mais comum e mais barata de verificar.
- Limpar os contatos dourados com uma borracha branca comum, num único sentido, removendo oxidação ou poeira que prejudique o contato elétrico entre o módulo e o slot.
- Testar módulo a módulo, numa placa-mãe com mais de um módulo instalado: isolar cada módulo em slots diferentes para descobrir se o defeito acompanha o módulo ou fica associado a um slot específico da placa-mãe.
- Testar em outra placa-mãe compatível (mesma geração DDR), quando disponível: se o POST volta a funcionar, confirma-se que o defeito é do módulo, não da placa-mãe original.
Cada passo elimina uma hipótese antes de avançar para a próxima, do mais simples (reencaixar) para o mais trabalhoso (testar em outra máquina) — a mesma lógica de isolamento por hipóteses do Capítulo 12 aplicada especificamente à memória RAM.
5.6 Compatibilidade física entre gerações: o chanfro¶
Módulos de memória de gerações DDR diferentes não são apenas eletricamente incompatíveis (cada geração opera numa tensão diferente); eles são também fisicamente incompatíveis por projeto. Cada módulo de memória possui um entalhe — o chanfro — posicionado em um ponto específico ao longo do conector de pinos; o slot correspondente na placa-mãe possui uma saliência física alinhada apenas com o chanfro daquela geração específica de memória.
O objetivo é puramente preventivo: como módulos de gerações diferentes têm dimensões quase idênticas, mas pinagem e tensões de operação distintas, conectar um módulo incompatível poderia danificar tanto a memória quanto a placa-mãe. O chanfro torna essa conexão errada fisicamente impossível — não por os módulos terem tamanhos diferentes (todos os módulos DIMM de desktop têm dimensões físicas praticamente idênticas, para simplificar o projeto das placas-mãe), mas exclusivamente pela posição do chanfro, que muda a cada geração (DDR, DDR2, DDR3, DDR4, DDR5), como mostra a Figura 5.3.
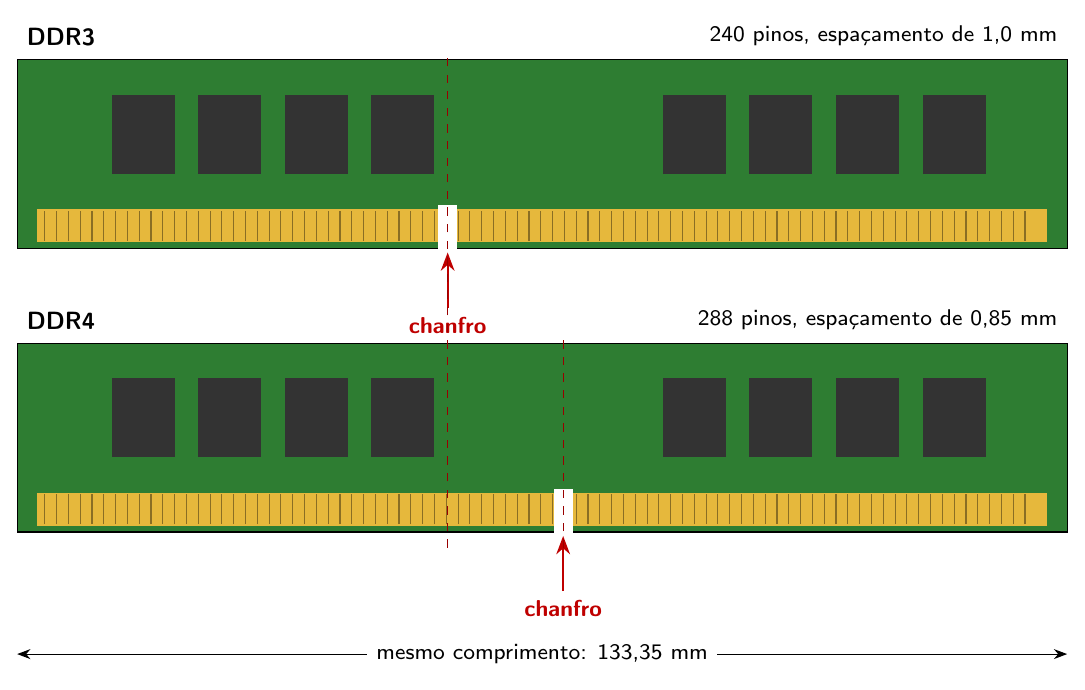
Na Figura 5.3, os dois módulos têm o mesmo comprimento, mas o chanfro da DDR4 fica em outra posição ao longo da fileira de contatos. Como o slot de cada geração tem a saliência no lugar do seu chanfro, um módulo DDR3 não entra num slot DDR4, e vice-versa.
Nota prática. Se um técnico sentir que está fazendo força para encaixar um componente de hardware, isso é sinal de que algo está errado — nenhum procedimento de manuseio de memória, processador ou demais componentes eletrônicos deve exigir força. É necessário parar e reavaliar o encaixe.
Existe ainda uma diferença de tamanho físico entre memórias de notebook e de desktop: os módulos de notebook (SO-DIMM) são fisicamente menores, para otimizar espaço, e não encaixam no slot de desktop (DIMM), nem o contrário. Existem adaptadores que permitem usar um módulo SO-DIMM num slot de desktop, mas não há como fazer o caminho inverso.
5.7 Dual Channel e Flex Mode¶
Uma mesma geração de memória tem um limite de velocidade determinado pela tecnologia da sua célula. O Dual Channel é uma estratégia para superar esse limite sem depender de uma nova geração tecnológica: em vez de escrever um dado inteiro sequencialmente em um único chip de memória, o sistema divide o dado (técnica chamada em inglês de striping) e o escreve simultaneamente em dois ou mais módulos de memória idênticos, através de canais distintos.
Exemplo. Considere uma memória capaz de escrever a 10 MB por segundo e um arquivo de 100 MB a ser carregado da memória secundária para a memória primária. Usando um único módulo, a escrita levaria 10 segundos. Dividindo o arquivo ao meio e escrevendo 50 MB em cada um de dois módulos idênticos simultaneamente, cada metade leva 5 segundos — e, como as duas escritas ocorrem em paralelo, o tempo total cai de 10 para 5 segundos. A divisão e a recomposição do dado são feitas pelo próprio controlador de memória, em hardware, sem custo para o sistema operacional.
Para o Dual Channel funcionar de forma ideal, o cenário recomendado é usar módulos idênticos — mesmo fabricante, mesma frequência de trabalho, mesma tensão de operação — e instalá-los nos slots corretos indicados no manual da placa-mãe. Quando não há dois módulos idênticos disponíveis, é possível usar o Flex Mode: módulos de capacidades ou frequências diferentes trabalham parcialmente em Dual Channel, mas a frequência de trabalho do conjunto fica limitada pelo módulo mais lento e a capacidade em Dual Channel, pelo módulo menor.
Exemplo (Flex Mode). Considere um módulo de 10 GB e outro de 5 GB, ambos com a mesma taxa de transferência (10 MB/s). Ao escrever um arquivo de 100 MB, o sistema consegue fazer o split de 50 MB para cada módulo — e os dois terminam em 5 segundos, desde que o módulo menor ainda tenha espaço correspondente disponível. Na prática, isso significa que apenas 10 GB dessa configuração de 15 GB totais (o dobro da capacidade do módulo menor) se beneficiam da velocidade dobrada do Dual Channel; os 5 GB excedentes do módulo maior funcionam como espaço comum, sem ganho de velocidade — o sistema nivela por baixo, limitado pelo módulo menor tanto em capacidade combinada quanto em frequência de trabalho.
Nota prática (quiz de mercado). Existe diferença entre usar um único módulo de 8 GB ou dois módulos de 4 GB somando os mesmos 8 GB? Sim: se a placa-mãe suportar Dual Channel, dois módulos entregam desempenho sensivelmente melhor do que um único módulo da mesma capacidade total. Curiosamente, o mercado às vezes cobra mais caro por um kit de dois módulos idênticos (por exemplo, 2×16 GB) do que por um único módulo de capacidade equivalente (1×32 GB) — o que não invalida a vantagem técnica do Dual Channel, apenas reflete dinâmica de preços e demanda.
Atualização de mercado (setembro de 2026). Pesquisa de preços real: um módulo único de 32 GB custava R$ 3.800, um kit de 2×16 GB custava R$ 4.300, e um kit de 4×8 GB custava R$ 2.890 — confirmando que a relação de preço entre configurações não segue uma lógica simples de "quanto mais peças, mais caro": nesse caso, o kit mais fragmentado saiu mais barato que as outras duas opções.
Nota prática (armadilha comum). Conectar módulos de memória em slots que não formam um par de Dual Channel válido (fora da combinação indicada no manual da placa-mãe) é um erro silencioso: o sistema operacional continua enxergando a capacidade total corretamente, mas sem o ganho de desempenho do canal duplo — um técnico que não verificar essa configuração pode entregar um computador funcionando "normal", porém performando abaixo do potencial pago pelo cliente.
Por que não escala indefinidamente. Colocar quatro módulos numa placa com controlador Quad Channel dobra, em teoria, a largura de banda do Dual Channel, mas o ganho percebido costuma ser bem menor: a maioria dos programas não consegue aproveitar tanta largura de banda, e coordenar quatro canais exige um controlador de memória mais sofisticado. É um exemplo do princípio mais geral de que, em engenharia, ganho de desempenho não aparece do nada — por isso placas-mãe com Quad Channel são bem mais caras e, em geral, voltadas a estações de trabalho e servidores.
Multiplicar canais não é a única estratégia da indústria para superar limites de desempenho de memória — apenas a mais comum em placas-mãe convencionais. Uma alternativa recente e notável é a memória unificada (Unified Memory), adotada pela Apple a partir da linha de processadores M (M1, M2, M3...): em vez de módulos de RAM instalados em slots, distantes do processador e conectados por um barramento tradicional, os chips de memória são posicionados fisicamente ao lado do próprio processador dentro do mesmo encapsulamento (package) e compartilhados entre CPU, GPU e demais núcleos especializados do chip — em vez de a GPU ter sua própria memória dedicada e separada da RAM do sistema, como é comum em arquiteturas com placa de vídeo discreta. Essa proximidade física reduz a latência de acesso e elimina a cópia de dados entre memórias separadas de CPU e GPU, à custa de menor flexibilidade: a memória deixa de ser um módulo substituível pelo usuário, ficando soldada e com capacidade definida já na compra do equipamento [11] — o mesmo compromisso entre integração e modularidade visto nos perfis de máquina da Seção 1.11.2.
Em números concretos, a evolução de largura de banda dessa arquitetura ilustra o ritmo da corrida: o Apple M1 original (2020), pioneiro do conceito, oferecia até 16 GB de memória unificada a ~68 GB/s; a variante "Ultra" da mesma família chegou a 128 GB a ~800 GB/s. A AMD seguiu a mesma estratégia com sua linha Ryzen AI Max, e a NVIDIA com o RTX Spark (Capítulo 4, §4.2), oferecendo até 128 GB a ~256 GB/s — para efeito de comparação, uma configuração convencional de RAM DDR5 em dual channel opera na faixa de ~100 GB/s.
Trade-offs para IA local. Em 2026, escolher entre GPU dedicada e memória unificada para rodar modelos de IA localmente é, em essência, trocar velocidade por capacidade. A VRAM de uma GPU dedicada tem largura de banda muito alta, porém em quantidade limitada e custo elevado por gigabyte (uma placa com 32 GB de VRAM custou da ordem de R$ 20 mil em 2026, só a placa de vídeo). A memória unificada oferece muito mais capacidade por um custo menor, permitindo modelos maiores, porém a uma largura de banda menor — logo, respostas mais lentas. Soluções híbridas (dividir o modelo entre vários computadores em cluster, ou servidores com várias GPUs) combinam capacidade e velocidade a um custo bem maior. O software também precisa estar otimizado para a plataforma (o framework MLX, por exemplo, foi criado pela própria Apple para os seus chips). Não há resposta única: a escolha depende do orçamento, do modelo e do problema — e de fatores não técnicos, como o sigilo dos dados: quando as informações não podem sair da organização (por força da LGPD, por exemplo), alugar processamento em nuvem deixa de ser alternativa e justifica o custo de um servidor local.
5.8 Cache e o princípio da localidade¶
A cache é a resposta da indústria ao gargalo de von Neumann (Capítulo 2, §2.7), e já apareceu duas vezes neste livro: no topo da pirâmide de memória (Seção 1.10.3) e dentro de cada núcleo do processador (Capítulo 4, §4.5). O termo cache designa, ao mesmo tempo, um conceito e um componente de hardware específico — e é importante não confundir os dois.
Como conceito, cache é a estratégia de trazer, antecipadamente, dados de uma memória mais lenta para uma memória mais rápida, com base na expectativa de que esses dados serão necessários em breve. Essa estratégia se apoia no princípio da localidade: quando um programa acessa uma determinada posição de memória, há alta probabilidade de que ele também precise, em seguida, de posições adjacentes a ela.
Exemplo. Ao abrir um arquivo PDF, o sistema não lê apenas o byte solicitado no exato instante da requisição: como o disco tem acesso sequencial e o arquivo tende a estar gravado numa mesma região do disco, o sistema aproveita que a cabeça de leitura já está posicionada ali e lê um bloco inteiro ao redor da posição pedida, guardando-o numa memória rápida — antecipando pedidos futuros em vez de repetir o processo de acesso sequencial, que é caro em tempo.
Esse mesmo princípio é usado fora do hardware de um computador local — como antecipado na Seção 1.10.4: um serviço de streaming de vídeo, por exemplo, antecipa a demanda por um lançamento popular trazendo seus dados de um armazenamento mais lento para um armazenamento mais rápido antes mesmo de a maior parte dos usuários assistir.
Quando o dado antecipado é efetivamente solicitado em seguida, ocorre um cache hit; quando o dado solicitado não está na memória cache e precisa ser buscado na memória mais lenta, ocorre um cache miss.
Como hardware, a cache da CPU é a memória física, construída em tecnologia SRAM (Seção 5.2), localizada dentro do próprio processador. Ela é organizada em níveis:
- Cache L1 — a menor e mais rápida, exclusiva de cada núcleo, geralmente subdividida em cache de instrução (o código do programa) e cache de dado.
- Cache L2 — maior e um pouco mais lenta que a L1, também exclusiva de cada núcleo.
- Cache L3 — a maior das três, compartilhada entre todos os núcleos do processador.
Exemplo. Ao solicitar um dado, o processador primeiro verifica a cache L1; se houver cache miss, verifica a L2; se houver novo miss, verifica a L3; e apenas se também não encontrar ali, vai buscar o bloco de dados na memória RAM (usando Dual Channel, se disponível), trazendo-o de volta para as camadas de cache. O AMD Ryzen 9 5900HX, por exemplo, especifica 16 MB de cache L3 compartilhada entre seus 8 núcleos e, para cada núcleo, 512 KB de cache L2 e 64 KB de cache L1 (32 KB de dados + 32 KB de instrução) — números que aparecem diretamente na página de especificações técnicas do fabricante [4]. A Figura 5.4 mostra esse caminho.
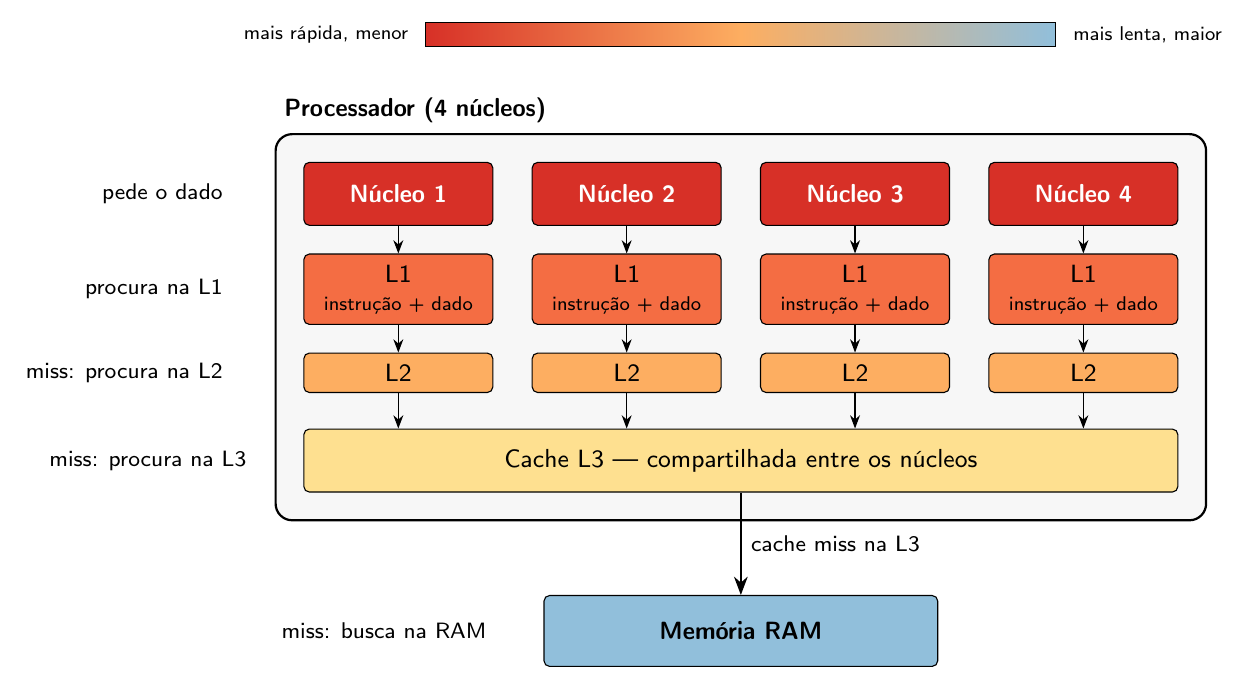
Na Figura 5.4, quanto mais perto do núcleo, menor e mais rápida a memória. Cada núcleo tem suas próprias L1 e L2; a L3 é uma só para todos. Um pedido de dado só desce para o nível seguinte quando não é encontrado no atual (cache miss), e só chega à RAM se faltar em todos os níveis de cache. As cores seguem a mesma escala de velocidade da pirâmide de memória do Capítulo 1 (Figura 1.5).
Cache versus Dual Channel. Embora ambos aumentem o desempenho da memória, operam em níveis e por mecanismos diferentes: o Dual Channel atua ao nível da memória RAM, dividindo (striping) e recompondo um mesmo dado entre módulos distintos para ganhar velocidade de escrita e leitura simultânea. O cache atua ao nível da CPU, antecipando e mantendo próximos dados que provavelmente serão requisitados, com base no princípio da localidade. Um não substitui o outro — ambos coexistem no mesmo sistema, otimizando pontos diferentes do caminho entre o processador e o armazenamento.
| Recurso | Nível de atuação | Mecanismo | Objetivo |
|---|---|---|---|
| Cache (L1/L2/L3) | CPU | Antecipa dados prováveis com base no princípio da localidade | Reduzir tempo de espera por dados já previstos |
| Dual Channel | Memória RAM | Divide e recompõe (striping) um dado entre módulos simultâneos | Aumentar a taxa de leitura/escrita da RAM |
5.9 Memória virtual (swap)¶
A cache traz dados de uma memória mais lenta para uma mais rápida; a memória virtual faz o caminho inverso — usa uma memória mais lenta para simular mais memória rápida do que existe. Todo processo em execução precisa estar carregado, ao menos parcialmente, em memória RAM. Quando a soma da memória exigida pelos programas em execução excede a capacidade física de RAM instalada, o sistema operacional recorre a um recurso chamado memória virtual: ele reserva um espaço de armazenamento secundário e o trata como se fosse uma extensão da memória primária, "mentindo" para o sistema sobre a quantidade de RAM realmente disponível. No Linux, essa área reservada é chamada de swap.
O grande custo desse recurso é o desempenho: a memória secundária usada como swap é ordens de grandeza mais lenta do que a RAM, então o sistema como um todo fica visivelmente mais lento sempre que depende de memória virtual.
Exemplo. Ao processar um programa de linguagem natural que precisava tokenizar grandes volumes de texto, o autor precisou expandir sucessivamente a memória RAM disponível: começando com 16 GB, depois testando com 32 GB e 64 GB emprestados, até finalmente montar um computador dedicado com 128 GB de RAM. Mesmo assim, o sistema operacional precisou recorrer à memória virtual, chegando a usar cerca de 210 GB no pico da execução — 128 GB de RAM física somados a aproximadamente 82 GB de espaço em SSD alocados como swap — antes de estabilizar em torno de 30 GB de uso real após a conclusão da etapa mais pesada do processamento. Uma alternativa mais barata seria configurar um SSD disponível inteiramente como área de swap: o programa rodaria de forma extremamente lenta, mas sem exigir a compra de um novo computador.
Nota prática. Computadores mais antigos, com pouca memória RAM, dependiam fortemente de memória virtual mesmo em tarefas cotidianas (como alternar entre poucos aplicativos abertos), o que explica boa parte da lentidão percebida nesses equipamentos. Em notebooks modernos com pouca RAM soldada, esse uso constante de swap tem ainda um custo de desgaste, discutido na Seção 5.12.
Diferenças entre sistemas operacionais. A política de quando e quanto usar memória virtual é uma característica de software que varia entre sistemas operacionais e entre versões — não há uma regra fixa documentada de forma definitiva. Em linhas gerais: o macOS tende a ser mais agressivo, antecipando o uso de swap antes de a RAM se esgotar por completo, de forma que o usuário dificilmente perceba; o Windows usa o espaço livre disponível sem reservar uma área fixa com antecedência; e o Linux, no processo de instalação, tradicionalmente reserva uma partição de swap dedicada — embora distribuições mais recentes cada vez mais ofereçam, como padrão, um arquivo de swap ou o recurso zram em vez de uma partição fixa.
Historicamente, o Windows já ofereceu, através do recurso ReadyBoost (introduzido no Windows Vista, em 2006, e aprimorado no Windows 7, em 2009), a possibilidade de usar um pendrive como área de swap — a memória flash do pendrive, mais rápida que um HD, acelerava computadores com pouca RAM [14]. O recurso perdeu relevância depois que SSDs (também baseados em memória flash) se tornaram o padrão de armazenamento secundário.
5.10 Armazenamento magnético: o disco rígido (HD)¶
Até aqui, o capítulo tratou da memória primária e dos recursos que a aceleram. As próximas seções descem à base da pirâmide, a memória secundária, começando pela tecnologia mais antiga ainda em uso. O disco rígido (HD, hard disk) é a memória secundária mais tradicional, e sua célula de memória é de natureza magnética. Fisicamente, um HD é composto por:
- Um ou mais pratos (platters) — discos rígidos girando em alta rotação, onde os dados são efetivamente gravados.
- Uma cabeça de leitura e escrita eletromagnética, posicionada na ponta de um braço atuador, que se movimenta sobre a superfície do prato.
A escrita ocorre porque uma corrente elétrica variável na cabeça de leitura/escrita gera um campo eletromagnético, que magnetiza uma região microscópica do prato numa polaridade norte-sul ou sul-norte — cada orientação corresponde a um bit 0 ou 1.
Uma vez magnetizada, a região do disco mantém sua orientação sem necessidade contínua de energia — daí a não volatilidade do HD. O dado só é perdido se um novo campo magnético externo suficientemente forte for aplicado sobre a região gravada, o que reescreve (ou corrompe) a informação ali contida. Essa é, inclusive, uma técnica legítima de destruição segura de dados.
Como a cabeça de leitura/escrita precisa se posicionar fisicamente sobre a trilha correta e aguardar a rotação do prato até o setor desejado passar por baixo dela, o HD tem acesso sequencial: o tempo de acesso depende da posição física do dado no disco, ao contrário do acesso aleatório da memória RAM. Cada face de cada prato é organizada em trilhas (círculos concêntricos) subdivididas em setores; o endereço de um dado no disco é dado pela combinação face/trilha/setor.
Um HD com múltiplos pratos acrescenta mais uma coordenada: além da face, da trilha e do setor, é preciso saber em qual prato está o dado. A Figura 5.5 mostra essas partes [22].
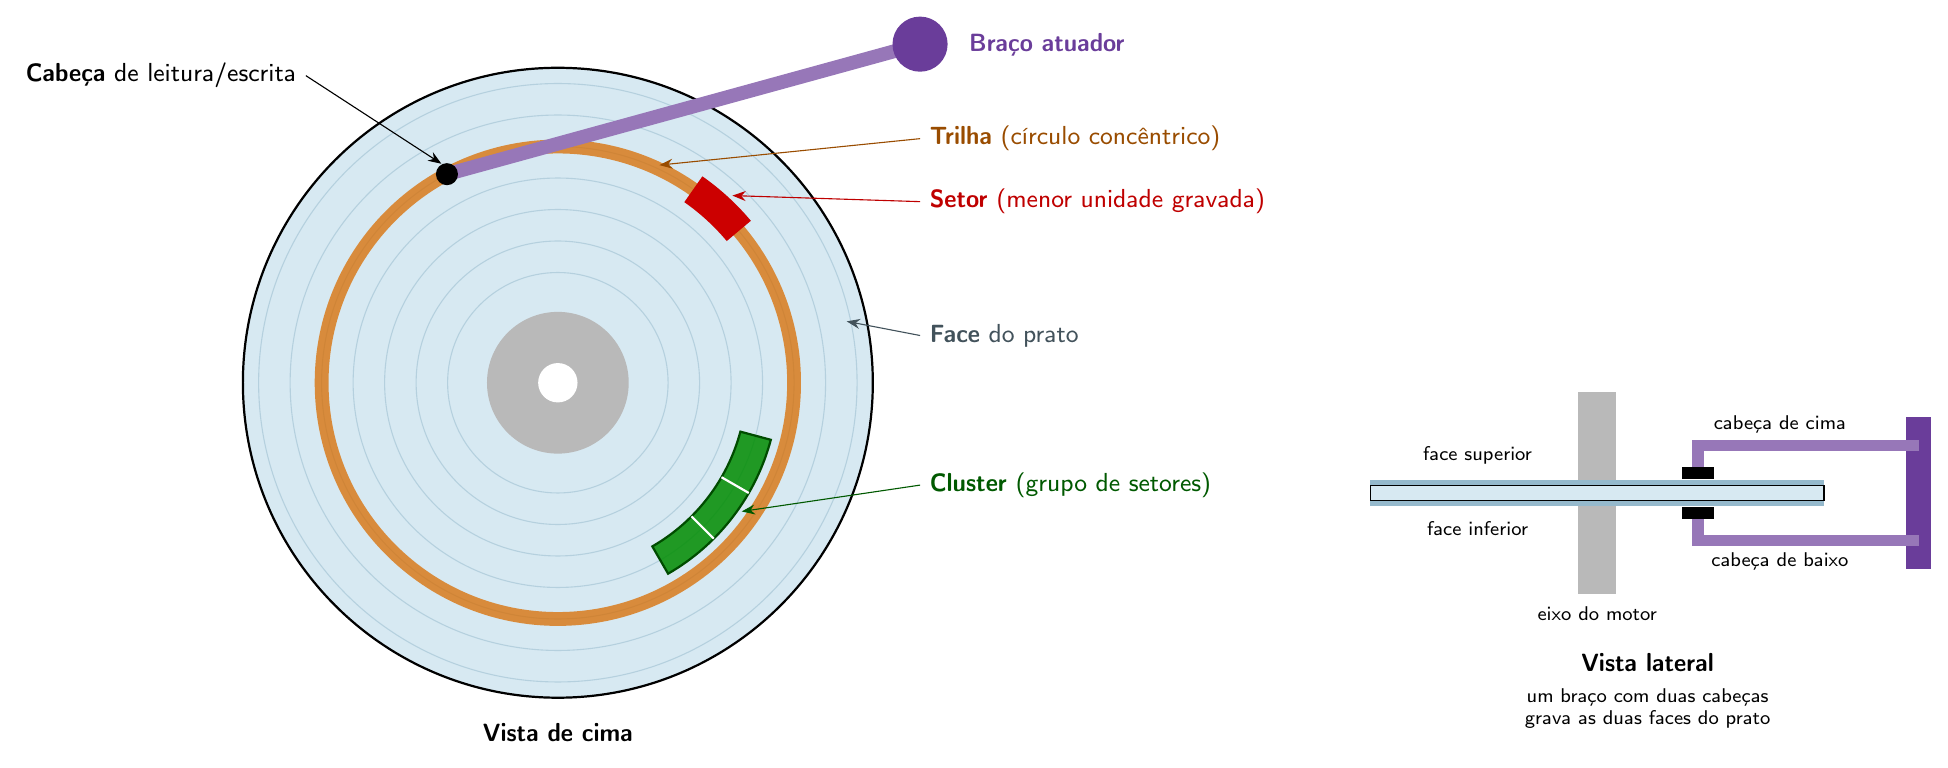
O endereço de um dado no HD combina as partes indicadas na Figura 5.5: em qual face do prato ele está, em qual trilha (o círculo concêntrico) e em qual setor (o trecho da trilha). Como as duas faces de cada prato são gravadas, o braço atuador leva uma cabeça para cada face, e todas se movem juntas.
A parte interna de um HD tem propositalmente muito pouca eletrônica visível: a maior parte dos componentes eletrônicos fica concentrada numa placa controladora externa, isolada da região magnética, para evitar contaminação eletromagnética dos dados gravados.
Por depender de peças móveis — motor, prato girando, braço atuador —, o HD tem vulnerabilidades de nascença: desgaste mecânico ao longo do tempo (fadiga de peças em movimento), risco de dano por impacto físico enquanto o disco está girando, e um tempo de vida útil finito determinado pela durabilidade dos componentes mecânicos. Em compensação, sua carcaça é lacrada hermeticamente — sem entrada de poeira ou partículas —, e, ao contrário das mídias óticas (Seção 5.12), o prato interno não é exposto a arranhões no uso normal.
Nota prática. Reparar internamente um HD com segurança normalmente exige um ambiente com nível de partículas por metro cúbico comparável ao de uma sala de cirurgia — profissionais de recuperação de dados costumam operar em salas limpas certificadas (ISO Classe 5) justamente por isso [5]. Abrir a carcaça fora desse tipo de ambiente controlado é arriscado e pode inutilizar o disco, já que poeira que entre compromete a leitura — mas parte do próprio setor de recuperação de dados argumenta que uma bancada com fluxo de ar filtrado localizado pode reduzir esse risco sem exigir uma sala limpa completa [5]. Por isso, HDs trazem parafusos e adesivos de segurança que evidenciam violação.
Nota prática (avançada). Entre dois HDs idênticos, é possível, em alguns casos, recuperar um HD com a placa controladora queimada substituindo-a pela placa de um HD gêmeo saudável — desde que a mecânica e a gravação magnética original estejam intactas. Em alguns modelos, é necessário também transferir um chip de calibração específico entre as placas. É uma técnica de manutenção avançada, pouco praticada fora de laboratórios especializados de recuperação de dados.
Figura pendente
HD aberto com prato, braço atuador e cabeça de leitura/escrita identificados
5.11 Unidade de alocação: clusters e metadados¶
Seja magnético, como o HD, seja flash, como o SSD (Seção 5.12), todo sistema de armazenamento secundário organiza o espaço em disco numa unidade mínima de alocação chamada cluster. Um cluster funciona como uma gaveta de tamanho fixo: mesmo que um arquivo ocupe uma fração mínima dessa gaveta, o espaço inteiro do cluster fica reservado para aquele arquivo.
Exemplo. Um arquivo de texto simples (.txt) contendo apenas a letra "J" — o equivalente, em ASCII, a 8 bits — ocupa, ainda assim, um cluster inteiro no disco: com o tamanho de cluster padrão do NTFS (4 KB, para a maioria dos tamanhos de partição), esse arquivo de 1 byte ocupa 4 KB [6]. Adicionar mais conteúdo ao mesmo arquivo (por exemplo, mais uma letra) continua ocupando o mesmo cluster, até que o conteúdo exceda sua capacidade — só então um segundo cluster é alocado. Atenção: essa relação vale para um arquivo de texto simples; um documento .docx equivalente ocupa vários KB a mais, mas essa diferença extra vem do formato do arquivo em si (o .docx é um contêiner ZIP/XML com metadados e estrutura de pacote própria), não do tamanho do cluster — são dois fenômenos distintos que não devem ser confundidos.
O tamanho do cluster é uma escolha de engenharia com consequências em ambas as direções: clusters maiores reduzem o esforço de endereçamento (menos gavetas para gerenciar), mas desperdiçam mais espaço em arquivos pequenos; clusters menores reduzem o desperdício, mas aumentam o número de endereços que o sistema precisa gerenciar. Esse tema será retomado, junto com o processo de formatação, no Capítulo 6 (§6.2 e §6.3).
Associado a cada arquivo existe um conjunto de metadados — dados sobre o próprio dado: nome, extensão, tamanho, datas e quais clusters ele ocupa (o que também permite saber quais clusters estão livres). Esses metadados ficam registrados no disco separadamente do conteúdo do arquivo, em estruturas mantidas pelo sistema de arquivo: no NTFS, a Master File Table (MFT) guarda as informações necessárias para localizar cada arquivo [17]; no ext4, do Linux, cada arquivo tem um inode com seus carimbos de tempo, permissões e o mapa dos blocos que ocupa [18]. Não se deve confundi-los com a tabela de partição, que registra apenas onde cada partição começa e termina no disco [19] (ambos aprofundados no Capítulo 6, §6.2 e §6.5).
Outra confusão comum envolve a capacidade anunciada de um dispositivo de armazenamento e a capacidade reconhecida pelo sistema operacional. Fabricantes costumam anunciar capacidade em múltiplos de 1.000 (o padrão do Sistema Internacional de Unidades — kilo, mega, giga como potências de dez), enquanto sistemas operacionais tradicionalmente calculam em múltiplos de 1.024 — a progressão em potências de dois da Seção 1.10.3. Um dispositivo anunciado com "16 GB" (16 bilhões de bytes) aparece, portanto, com cerca de 14,9 GB quando visualizado pelo sistema operacional (16 × 10⁹ ÷ 2³⁰ ≈ 14,9).
5.12 Memória flash¶
A memória flash é a tecnologia por trás do SSD (Solid State Drive — unidade de estado sólido), de pendrives e da memória de armazenamento da grande maioria dos smartphones atuais. Sua célula de memória é construída com um tipo específico de transistor de efeito de campo chamado MOSFET, dotado de uma estrutura adicional chamada porta flutuante (floating gate).
A presença ou ausência de elétrons retidos na porta flutuante altera a tensão necessária para que corrente passe entre os dois terminais do transistor (chamados de dreno e fonte) — esse comportamento é o que permite implementar, em hardware, o equivalente a um teste "se-então" (if) que determina se a célula representa um bit 0 ou 1. Escrever um bit consiste em aplicar uma tensão que empurra elétrons para dentro ou para fora da porta flutuante, atravessando a fina camada de óxido isolante.
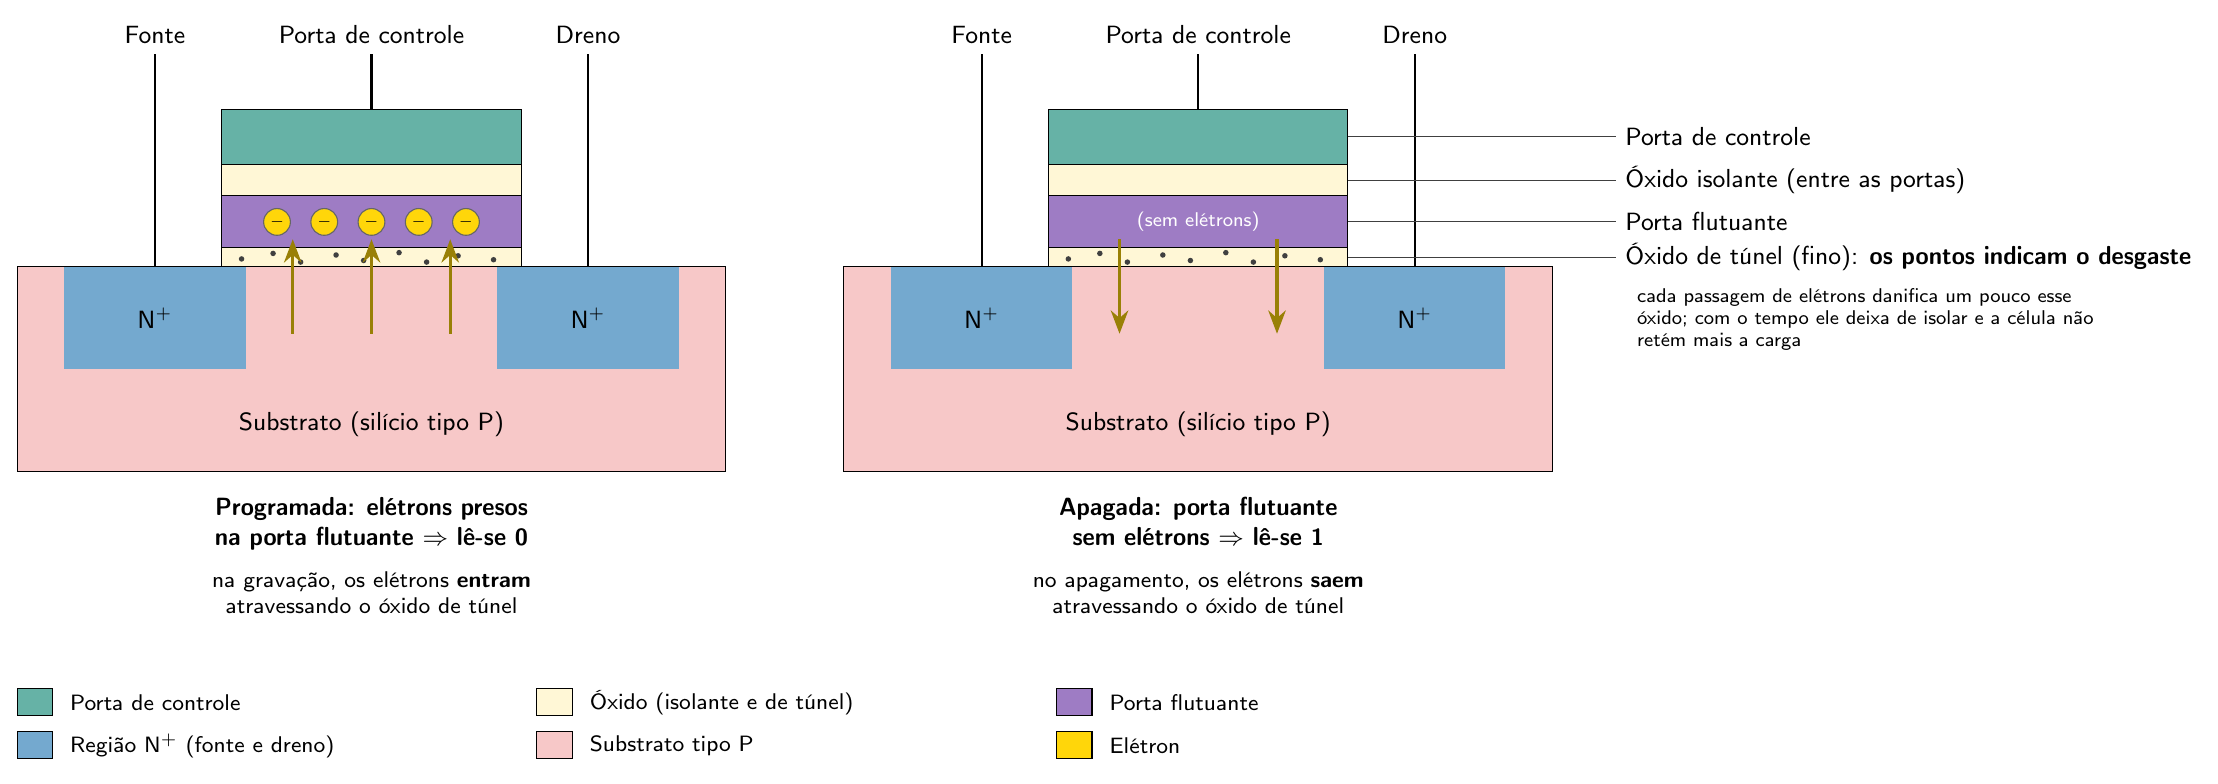
Como mostra a Figura 5.6, a gravação e o apagamento fazem elétrons atravessarem o óxido de túnel, a camada fina entre o substrato e a porta flutuante. Com elétrons presos, a célula está programada e é lida como 0; sem eles, está apagada e é lida como 1 — a convenção usada pelos fabricantes de memória flash NAND. Cada travessia danifica um pouco esse óxido (os pontos na figura), e é esse desgaste que limita o número de escritas de uma memória flash.
É exatamente essa travessia repetida de elétrons que explica as duas principais fraquezas da memória flash:
- Número limitado de operações de escrita. Cada vez que elétrons atravessam a camada de óxido, ela se desgasta um pouco — de forma análoga a uma borracha que, ao apagar repetidamente, vai afinando o papel até rasgá-lo. Depois de um número finito de ciclos de escrita (de cerca de mil ciclos nas tecnologias mais densas e baratas até cerca de 100 mil ciclos nas tecnologias mais duráveis, dependendo de como a célula é fabricada), a célula perde a capacidade de reter dados de forma confiável.
- Necessidade de reenergização periódica. Mesmo sem novas escritas, a carga de elétrons retida na porta flutuante vaza lentamente ao longo do tempo, de forma análoga ao esvaziamento gradual de um capacitor. Um dado gravado numa memória flash e deixado sem uso por um período muito longo pode se tornar ilegível, porque a diferença de carga que originalmente distinguia um bit 0 de um bit 1 se dissipa. Um pendrive guardado por décadas sem ser conectado a um computador, portanto, não tem seus dados automaticamente preservados — a memória flash não é permanente da mesma forma que a magnetização de um HD.
Nota prática (upgrade de HD para SSD). Para o técnico, substituir o HD de um computador lento por um SSD é um dos upgrades de melhor custo-benefício, como antecipado na Seção 1.10.4: processador e RAM continuam os mesmos, mas o boot (a cópia do sistema operacional da memória secundária para a RAM, Capítulo 6, §6.6.3) passa a ler de uma célula muito mais rápida. O ganho vale mesmo que o SSD tenha bem menos capacidade que o HD substituído (por exemplo, 256 GB no lugar de 1 TB) e mesmo que seja ligado pelo mesmo conector SATA, porque vem da natureza da célula. Ligar o SSD por NVMe soma o ganho de uma interface mais rápida (Capítulo 10, §10.1.5).
Apesar dessas fraquezas, a memória flash apresenta vantagens decisivas para determinadas aplicações: ausência de partes móveis (logo, resistência a impactos e vibração), baixo consumo energético e volume físico reduzido — características que "casam" perfeitamente com dispositivos móveis. É por isso que praticamente 100% dos smartphones usam memória flash como armazenamento: por não ter partes móveis, o iPhone — lançado já com memória flash — é significativamente mais robusto à vibração e a impactos do que seria um dispositivo móvel equivalente baseado em HD.
Nota prática. É aqui que reaparece o custo de desgaste mencionado na Seção 5.9. Computadores modernos com memória flash soldada à placa e pouca RAM disponível (como certos notebooks lançados a partir de 2020) dependem fortemente de memória virtual (Seção 5.9), usando a própria memória flash soldada como área de swap. Como a memória flash tem um número finito de ciclos de escrita, esse uso intensivo acelera o desgaste da célula ao longo dos anos — e, como a memória é soldada (não modular), não há como substituí-la isoladamente quando ela falha. Esse é um dos fatores que explica a desvalorização acentuada desses equipamentos à medida que envelhecem. Um exemplo real e bastante discutido é o MacBook Air M1 (2020), vendido majoritariamente com apenas 8 GB de RAM soldada: o uso constante de memória virtual sobre o próprio SSD soldado acelera o desgaste da célula flash ao longo dos anos, num aparelho sem qualquer possibilidade de upgrade de RAM ou substituição isolada do armazenamento.
Do ponto de vista de organização interna, múltiplas células de memória flash formam páginas, e múltiplas páginas formam blocos — a unidade típica de apagamento na memória flash. Um SSD contém, além das próprias células flash, um chip controlador e, tipicamente, uma pequena quantidade de memória DRAM interna usada como cache: blocos de dados recentemente acessados são mantidos nessa DRAM interna (mais rápida que a própria flash) seguindo o mesmo princípio da localidade discutido na Seção 5.8.
A memória flash é historicamente descendente da família de memórias ROM (Read Only Memory): a ROM original era gravada uma única vez na fábrica; a PROM (Programmable ROM) podia ser gravada uma vez fora da fábrica; a EPROM (Erasable PROM) podia ser apagada por exposição à luz ultravioleta e regravada; e a EEPROM (Electrically Erasable PROM) podia ser apagada eletricamente, sem necessidade de luz ultravioleta — sendo essa a ancestral direta da memória flash moderna [7]. É também por descender dessa linhagem que a memória flash substituiu a ROM em aplicações como o firmware da placa-mãe (BIOS/UEFI, estudado no Capítulo 6, §6.6, e no Capítulo 7), que hoje pode ser atualizado justamente porque está gravado numa memória flash regravável.
Figura pendente
HD aberto ao lado de um SSD aberto, evidenciando ausência de partes móveis no SSD
5.13 Mídias óticas¶
As mídias óticas — CD, DVD e Blu-ray — armazenam dados através de uma célula de memória completamente distinta das anteriores: um ponto da superfície do disco que reflete ou não reflete um feixe de laser. A superfície tem pequenas depressões (pits) intercaladas com regiões planas (lands); um laser percorre essa superfície, um fotodetector registra as mudanças de reflexão nas passagens entre uma e outra, e é o padrão dessas transições que se converte de volta em dados binários.
Apesar da semelhança física, um CD não deve ser confundido com um disco de vinil: o disco de vinil grava a informação de forma analógica — o sulco físico reproduz diretamente a forma de onda sonora, amplificada mecanicamente pela agulha. O CD grava informação de forma digital: cada ponto da superfície representa exclusivamente um 0 ou um 1.
Assim como o HD, a mídia ótica tem acesso sequencial: a leitura começa por uma posição combinada entre fabricante e leitor (próxima ao centro do disco) e prossegue radialmente para fora. Como a gravação também começa perto do centro e avança para fora, um CD gravado pela metade mostra visivelmente a área gravada, de tonalidade diferente da área não utilizada.
A evolução de CD para DVD e para Blu-ray consistiu em reduzir o tamanho físico de cada célula de memória, permitindo mais dados no mesmo espaço — o que exige um laser de comprimento de onda menor (medido em nanômetros) e mais preciso tanto para gravar quanto para ler. O nome Blu-ray vem justamente do fato de seu laser operar no espectro azul, de comprimento de onda mais curto que o laser do DVD (vermelho, ~650 nm) e do CD (infravermelho próximo, ~780 nm — tecnicamente fora da faixa visível, ainda que próximo do vermelho) [8].
Em termos de capacidade, um CD armazena algo em torno de 700–800 MB; um DVD de camada única, cerca de 4,7 GB; e um Blu-ray, 25 GB numa única camada — chegando a 50 GB com dupla camada [13].
Por não estar protegida por uma carcaça lacrada como o HD, a superfície de uma mídia ótica é vulnerável a arranhões, que interferem diretamente na reflexão do laser e corrompem a leitura — o "CD riscado" clássico. Técnicas informais de reparo (como aplicar verniz ou pasta de polimento para remover uma fina camada superficial e expor uma superfície de reflexão menos danificada) funcionam apenas de forma limitada, já que removem também parte da camada onde o próprio dado está gravado.
Por fim, distingue-se o CD-ROM (gravado uma única vez na fábrica, sem possibilidade de regravação), o CD-R (gravável uma única vez pelo usuário) e o CD-RW (regravável), com a mesma lógica de gravação valendo para DVD e Blu-ray — uma progressão parecida com a da linhagem ROM, PROM e EPROM da Seção 5.12.
5.14 Nuvem, backup e estratégias de segurança de dados¶
O armazenamento em nuvem não constitui um novo tipo de célula de memória: é, na prática, um computador remoto (ou um conjunto de servidores) conectado à internet, armazenando dados nas mesmas tecnologias já estudadas neste capítulo — predominantemente HD e SSD, organizados dentro de sua própria pirâmide de hierarquia de memória, como qualquer outro computador. Provedores como Google Drive, OneDrive e Dropbox mantêm réplicas dos dados em servidores fisicamente distribuídos em diferentes localizações, o que aumenta a confiabilidade ao custo, por vezes, de menor velocidade de acesso.
Uma pergunta comum é: qual mídia de armazenamento secundário é a mais segura? A resposta é uma provocação: não existe uma mídia mais segura em termos absolutos. Cada tecnologia estudada neste capítulo tem um ponto fraco de natureza distinta:
| Mídia | Ponto fraco característico |
|---|---|
| HD (magnético) | Vulnerável a campos magnéticos fortes próximos; peças móveis se desgastam |
| SSD / pendrive (flash) | Número limitado de operações de escrita; perda de carga ao longo do tempo |
| CD/DVD/Blu-ray (ótica) | Vulnerável a arranhões na superfície de leitura |
| Nuvem | Depende de senha/acesso; exposta a questões de privacidade e disponibilidade de rede |
A segurança real de um dado não vem de escolher a "melhor" mídia, mas de criar redundância: manter cópias em mídias de natureza física diferente e em localizações físicas diferentes, já que cada tecnologia falha por um motivo diferente e um único desastre local não deve comprometer todas as cópias simultaneamente.
Exemplo. Um estudante de pós-graduação mantinha backups de sua dissertação de mestrado no laptop, num HD externo e num pendrive — mas todos os três dispositivos estavam guardados dentro da mesma mochila, que foi roubada. Apesar de ter três cópias redundantes em três mídias diferentes, a ausência de separação geográfica entre elas fez com que todas fossem perdidas simultaneamente, obrigando-o a refazer o trabalho do zero. O princípio de backup exige não apenas diversidade de mídia, mas também diversidade de localização.
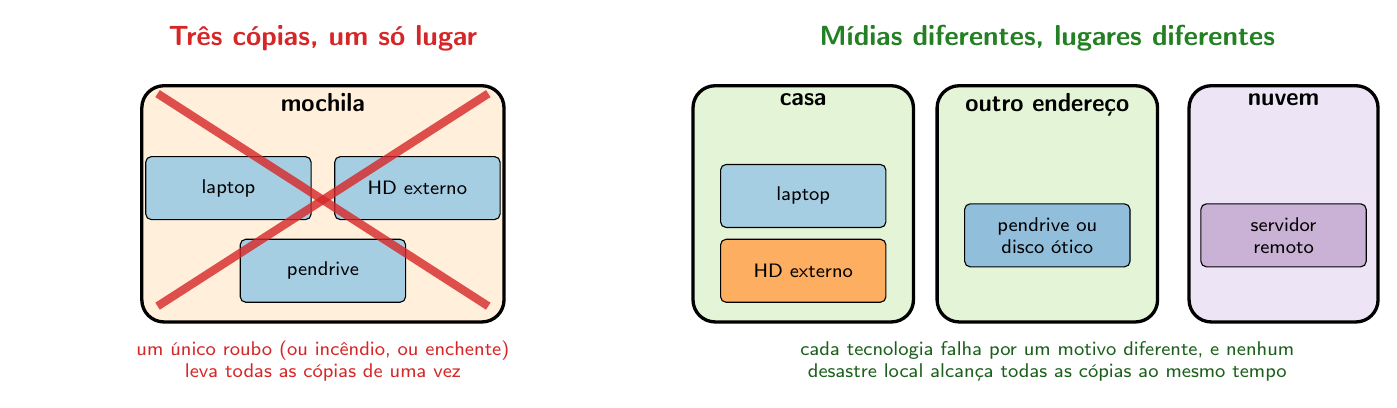
A Figura 5.7 contrapõe o caso da mochila a um arranjo seguro: as cópias continuam sendo três, mas agora em tecnologias diferentes e em lugares diferentes.
Redundância e longevidade no extremo: o Arctic Code Vault. Em fevereiro de 2020, o GitHub capturou um snapshot de todos os repositórios públicos ativos da plataforma (cerca de 21 TB) e o depositou no Arctic World Archive, um cofre numa mina de carvão desativada em Svalbard (Noruega), perto do banco global de sementes. Os dados foram gravados em filme de haleto de prata sobre poliéster, em imagens semelhantes a QR codes — nem flash nem magnética, por nenhuma delas garantir preservação por séculos —, e a fabricante do filme (Piql) declara durabilidade superior a mil anos [16]. É um "backup do backup do backup": não busca disponibilidade (ler o acervo exige escanear e decodificar o filme), e sim resistência a perdas de longo prazo. Mesmo esse projeto tem prazo, o que ilustra que nenhuma mídia dura para sempre.
5.15 Bit flip e memória ECC¶
A redundância também protege a memória primária — contra uma ameaça bem menos visível que o roubo de uma mochila. Um bit flip (também chamado soft error ou single-event upset, SEU) é a inversão espontânea do valor armazenado numa célula de memória — um 0 que passa a 1, ou vice-versa —, sem que a célula tenha sofrido qualquer dano físico permanente: se regravada com o valor correto, ela volta a funcionar normalmente. A literatura técnica — a partir de um estudo seminal da Intel, em 1978, que primeiro identificou o fenômeno em DRAM [9] — aponta duas causas físicas bem estabelecidas, ambas formas de radiação ionizante, hoje normatizadas por um padrão da indústria de testes de memória [10]:
- Raios cósmicos secundários. Partículas de altíssima energia vindas do espaço colidem com a atmosfera terrestre e produzem um chuveiro de partículas secundárias — na superfície da Terra, majoritariamente nêutrons. Um nêutron não tem carga elétrica e não perturba um circuito diretamente, mas, ao colidir com o núcleo de um átomo de silício do chip, pode gerar partículas carregadas secundárias, que então depositam carga suficiente para inverter o estado de um capacitor de DRAM (Seção 5.3) ou de um flip-flop de SRAM (Seção 5.2).
- Partículas alfa de contaminantes radioativos no encapsulamento. Os próprios materiais usados para embalar e soldar o chip (a "casca" plástica ou cerâmica do processador ou do módulo de memória) contêm, em quantidade mínima, traços de elementos radioativos residuais dos processos de mineração e refino usados para produzi-los. Esses traços emitem, de forma constante e previsível, partículas alfa — e, por estarem fisicamente muito próximos da própria célula de memória, essas partículas depositam carga da mesma forma que um nêutron secundário.
Bit flip não é o mesmo fenômeno que a vulnerabilidade do HD a campos magnéticos (Seção 5.10) nem que a perda de dados discutida na Seção 5.14. Um HD armazena dados por meio da orientação magnética de uma região do prato — por isso um ímã suficientemente forte de fato ameaça um HD, ao reescrever essa orientação. Uma célula de RAM, em contraste, armazena dado como carga elétrica (DRAM) ou como estado lógico de um circuito (SRAM) — não existe, na literatura sobre soft errors, um mecanismo estabelecido de bit flip por campo magnético externo; um ímã comum, mesmo forte, não tem como induzir diretamente a carga necessária para inverter um bit de RAM da forma como raios cósmicos e partículas alfa fazem. As duas ameaças — magnética para o HD, radiação ionizante para a RAM — têm mecanismos físicos distintos e não devem ser confundidas.
Memória ECC. Servidores costumam usar módulos de memória ECC (Error-Correcting Code), um tipo de RAM capaz de detectar e corrigir automaticamente um erro de bit flip de um único bit por palavra de memória, usando bits extras de paridade/verificação gravados junto com o dado. Quanto menor a litografia do chip de memória (Capítulo 4, §4.3) e quanto maior a quantidade total de memória instalada, maior a probabilidade estatística de que um bit flip ocorra em algum lugar do sistema. Num desktop doméstico, um bit flip ocasional é, na pior hipótese, uma tela azul isolada; num servidor operando 24 horas por dia com centenas de gigabytes de RAM, o mesmo tipo de erro, acumulado ao longo de meses, pode corromper silenciosamente um banco de dados inteiro — daí o uso de ECC ser padrão nesse perfil de máquina, e praticamente inexistente em desktops e notebooks comuns (Capítulo 1, §1.11.2).
A probabilidade de um bit flip também aumenta com a altitude, pela menor espessura de atmosfera disponível para blindar a radiação cósmica — data centers instalados em altitudes mais elevadas registram, mensuravelmente, taxas de falha um pouco maiores por esse motivo.
Caso documentado: a eleição belga de 2003. Em maio de 2003, em Schaerbeek (Bélgica), o sistema de votação eletrônica atribuiu a uma candidata 4.096 votos a mais do que era possível; a discrepância só foi notada porque o total dela superava o da própria lista do partido. A explicação oficial foi a "criação espontânea de um bit" na memória do sistema, e o número é revelador: 4.096 = 2¹², exatamente o valor que um único bit de peso 2¹² passando de 0 para 1 soma a um contador. Não é possível provar a causa física (raio cósmico é a hipótese mais aceita), mas o caso mostra como um único bit invertido pode alterar um resultado real [15].
Síntese do capítulo¶
Este capítulo aprofundou a hierarquia de memória introduzida no Capítulo 1, mostrando que cada nível dessa pirâmide — registradores e cache, memória RAM, e as diferentes formas de armazenamento secundário — deriva suas características de desempenho, custo e volatilidade diretamente da natureza física de sua célula de memória. Foram estudadas a evolução da memória primária (da SRAM estática à família DDR síncrona e dinâmica), os recursos que ampliam seu desempenho (cache, Dual Channel, memória virtual), as três grandes famílias de armazenamento secundário — magnética, flash e ótica —, cada uma com vantagens e fragilidades próprias, e as estratégias de backup e redundância que protegem esses dados. O capítulo fechou com o bit flip — a inversão espontânea de um bit por radiação ionizante — e a memória ECC que o corrige, aplicando à própria memória primária o mesmo princípio de redundância contra falha discutido a propósito do backup. Esses conceitos são retomados adiante, na ordem do livro: a formatação, os sistemas de arquivos e o gerenciamento de clusters e metadados — apenas introduzidos aqui na Seção 5.11 — são a camada de software que o Capítulo 6 estuda sobre a memória secundária; a memória flash do firmware reaparece na atualização de BIOS do Capítulo 7; a memória como componente vital ao POST, no Capítulo 9; as interfaces SATA e NVMe do armazenamento, no Capítulo 10 (§10.1.5); e o diagnóstico de módulos e mídias com defeito, no método de manutenção do Capítulo 12.
Referências¶
- COMPUTER HISTORY MUSEUM. "1970: MOS Dynamic RAM Competes with Magnetic Core Memory on Price." Memory & Storage — Timeline of Computer History. Disponível em: https://www.computerhistory.org/storageengine/; HENNESSY, John L.; PATTERSON, David A. Computer Architecture: A Quantitative Approach. 6. ed. Morgan Kaufmann, 2017, seção "SRAM Technology"/"DRAM Technology".
- JEDEC SOLID STATE TECHNOLOGY ASSOCIATION. JESD79-4: DDR4 SDRAM Standard; JESD79-5: DDR5 SDRAM Standard. Arlington, VA: JEDEC. Disponível em: https://www.jedec.org/standards-documents.
- HP. "DDR4 RAM: A Comprehensive Guide." Disponível em: https://www.hp.com/us-en/shop/tech-takes/what-is-ddr4-ram-and-how-to-install; KINGSTON TECHNOLOGY. "What is DDR4 Memory?" Disponível em: https://www.kingston.com/en/memory/ddr4-overview.
- AMD. Página de especificações técnicas do processador AMD Ryzen 9 5900HX.
- DRIVESAVERS. "Certified ISO Class 5 Cleanroom." Disponível em: https://drivesaversdatarecovery.com/why-us/certified-iso-class-5-cleanroom/; ROSSMANN GROUP. "You Do Not Need a Cleanroom for Data Recovery." Disponível em: https://rossmanngroup.com/data-recovery-myths/cleanroom-not-required-for-data-recovery.
- MICROSOFT. "Default cluster size for NTFS, FAT, and exFAT." Disponível em: https://mskb.pkisolutions.com/kb/140365.
- MALVINO, Albert Paul; BROWN, Jerald A. Digital Computer Electronics. 3. ed. Glencoe/McGraw-Hill, 1993, seções "9-2 PROMS AND EPROMS" e "EEPROM"; MONTEIRO, Mario A. Introdução à Organização de Computadores. 5. ed. Rio de Janeiro: LTC, seções "PROM"/"EPROM e EEPROM".
- TANENBAUM, Andrew S.; AUSTIN, Todd. Organização Estruturada de Computadores. 6. ed. São Paulo: Pearson Education do Brasil, 2013, seção 2.3.11 "Blu-ray"; COMPUTER HISTORY MUSEUM. "2000: Prototype blue laser disc stores HD video." Disponível em: https://www.computerhistory.org/storageengine/prototype-blue-laser-disc-stores-hd-video/.
- MAY, T. C.; WOODS, M. H. A new physical mechanism for soft errors in dynamic memories. In: Proceedings of the 16th Annual Reliability Physics Symposium. IEEE, 1978. p. 33–40. Publicado também como: MAY, T. C.; WOODS, M. H. Alpha-particle-induced soft errors in dynamic memories. IEEE Transactions on Electron Devices, v. 26, n. 1, p. 2–9, jan. 1979.
- JEDEC SOLID STATE TECHNOLOGY ASSOCIATION. JESD89B: Measurement and Reporting of Alpha Particle and Terrestrial Cosmic Ray Induced Soft Errors in Semiconductor Devices. Arlington, VA: JEDEC, 2021.
- APPLE. "Apple unveils M1, the first in a groundbreaking family of chips for Mac." Apple Newsroom, 2020. Disponível em: https://www.apple.com/newsroom/2020/11/apple-unveils-m1-the-first-in-a-groundbreaking-family-of-chips-for-mac/.
- TOM'S HARDWARE. "What Is CAS Latency in RAM? CL Timings Explained." Disponível em: https://www.tomshardware.com/reviews/cas-latency-ram-cl-timings-glossary-definition,6011.html.
- Blu-ray Disc Association (BDA). Especificação padrão de capacidade: 25 GB (camada única) e 50 GB (dupla camada); CD-DA (700–800 MB) e DVD-5 (~4,7 GB) conforme especificações originais dos formatos.
- SOURCEDADDY. "Windows ReadyBoost." Windows 7 Tutorial. Disponível em: https://sourcedaddy.com/windows-7/windows-readyboost.html; MICROSOFT. "ReadyBoost changes in Windows 7." Microsoft Learn (archive). Disponível em: https://learn.microsoft.com/en-us/archive/blogs/7/readyboost-changes-in-windows-7.
- WIKIPEDIA. Electronic voting in Belgium. Disponível em: https://en.wikipedia.org/wiki/Electronic_voting_in_Belgium.
- GITHUB. GitHub Archive Program: Arctic Code Vault. Disponível em: https://archiveprogram.github.com/arctic-vault/.
- MICROSOFT. "Master File Table." Microsoft Learn. Disponível em: https://learn.microsoft.com/en-us/windows/win32/devnotes/master-file-table.
- THE LINUX KERNEL DOCUMENTATION. "ext4 Data Structures and Algorithms — Index Nodes." Disponível em: https://docs.kernel.org/filesystems/ext4/inodes.html.
- UEFI FORUM. UEFI Specification 2.11, cap. 5, "GUID Partition Table (GPT) Disk Layout". Disponível em: https://uefi.org/specs/UEFI/2.11/05_GUID_Partition_Table_Format.html.
- WIKIPEDIA. "DDR SDRAM"; "Synchronous dynamic random-access memory" (seção sobre as gerações DDR). Disponível em: https://en.wikipedia.org/wiki/DDR_SDRAM; https://en.wikipedia.org/wiki/Synchronous_dynamic_random-access_memory.
- RABAEY, Jan M.; CHANDRAKASAN, Anantha; NIKOLIĆ, Borivoje. Digital Integrated Circuits: A Design Perspective. 2. ed. Upper Saddle River: Prentice Hall, 2003, cap. 5, seção "Power, Energy, and Energy-Delay".
- WIKIPEDIA. Disk sector. Disponível em: https://en.wikipedia.org/wiki/Disk_sector.